
¿Se puede investigar al consumidor sin consumidores? Lo que dicen los estudios sobre los respondentes sintéticos
La inteligencia artificial promete encuestas sin encuestados: perfiles simulados que responden en minutos y a una fracción del costo. Pero los estudios publicados en 2026 muestran que, aunque pueden aproximarse a algunos resultados generales, existen diferencias importantes al analizar preferencias, segmentos y cambios en el tiempo. Analizamos qué encontraron, cuándo pueden ser útiles y qué deberían evaluar las marcas antes de tomar decisiones con estos datos.
La promesa: encuestas sin encuestados
En los últimos años, una propuesta ha ganado espacio en la conversación sobre investigación de mercados: los respondentes sintéticos. Se trata de perfiles simulados con inteligencia artificial que contestan encuestas o entrevistas como si fueran consumidores reales.
El funcionamiento es sencillo de explicar. Un modelo recibe la descripción de una persona —edad, género, región, características demográficas y, en ocasiones, respuestas previas— y genera predicciones sobre cómo podría responder a un cuestionario. Algunas soluciones los presentan como «gemelos digitales» o paneles sintéticos.
La promesa es atractiva: resultados en minutos, sin trabajo de campo y a una fracción del costo. Para equipos con presupuestos ajustados y plazos cortos, la posibilidad de explorar ideas o anticipar reacciones sin levantar una encuesta completa puede resultar especialmente interesante.
Pero la pregunta de fondo es otra: ¿qué tan bien representan estas respuestas lo que piensan, prefieren y hacen las personas reales?
En 2026, varios estudios pusieron a prueba esta tecnología y ofrecen evidencia para evaluar tanto su potencial como sus limitaciones.
Lo que encontró Pew Research Center: diferencias de más de 12 puntos
En septiembre de 2026, Pew Research Center publicó un experimento en el que creó «gemelos digitales» de participantes reales de su American Trends Panel. Utilizó información demográfica y respuestas previas para generar perfiles sintéticos, a los que aplicó tres encuestas realizadas entre enero y abril de 2026. Después comparó sus respuestas con las de las personas reales.
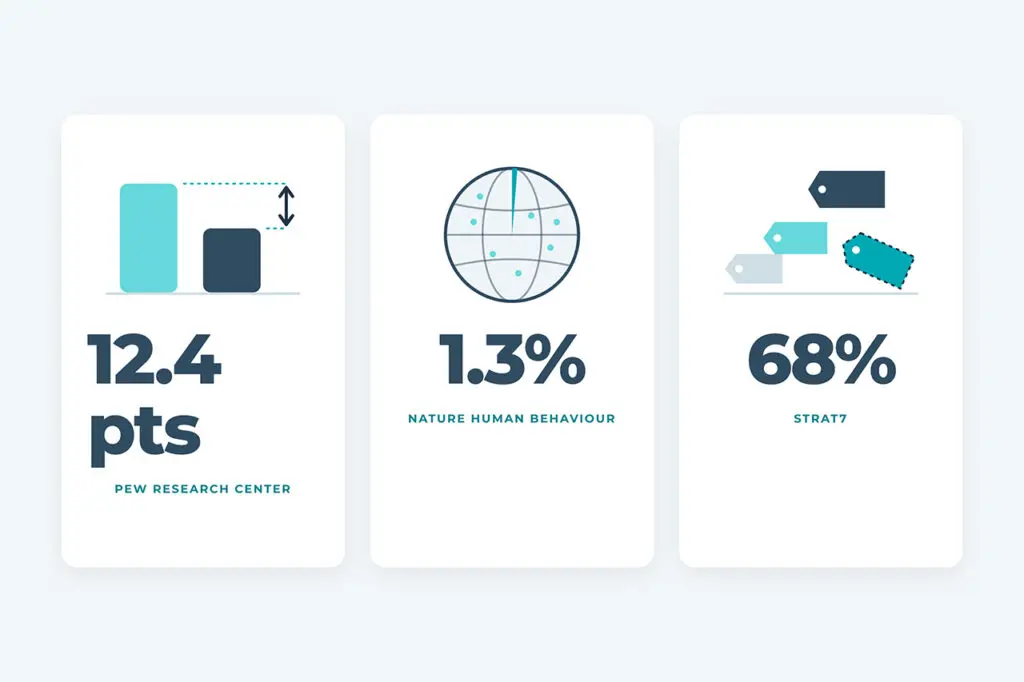
El resultado fue una diferencia promedio absoluta de 12.4 puntos porcentuales entre las respuestas sintéticas y las reales. Al analizar distintos grupos, las diferencias fueron mayores en algunos casos: 13.9 puntos entre adultos hispanos, 15.1 entre adultos negros y 16.1 entre republicanos o personas que se inclinaban por ese partido.
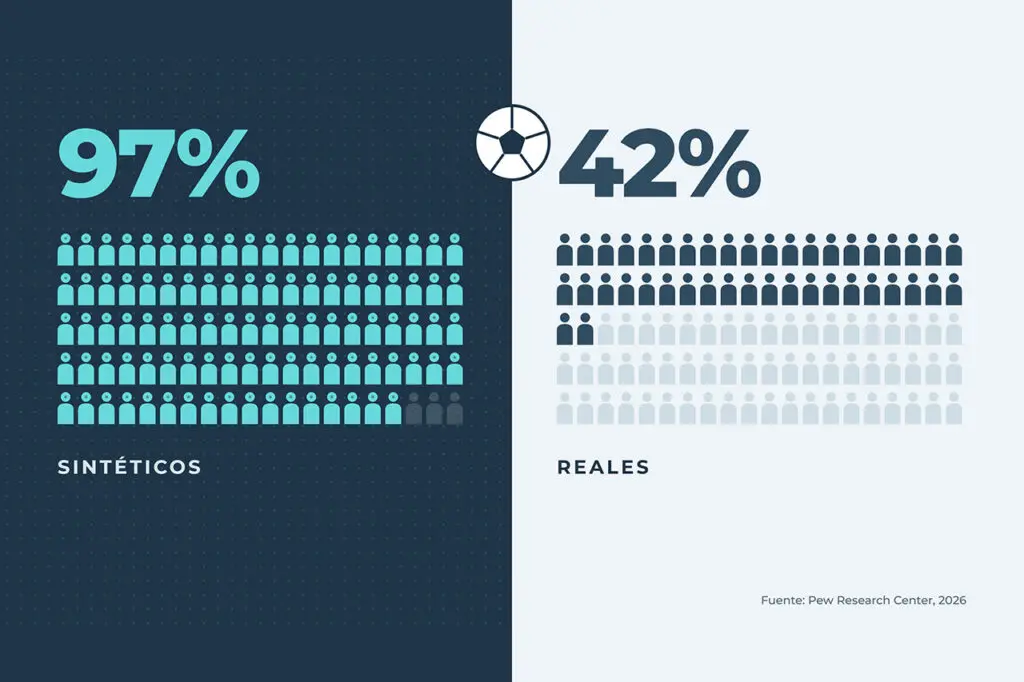
Un ejemplo ilustra la magnitud de estas diferencias. Ante la pregunta sobre qué tan probable era seguir el Mundial, el 97% de los adultos hispanos simulados respondió que era al menos algo probable, frente al 42% de los hispanos reales en Estados Unidos.
El estudio también encontró diferencias en la diversidad de respuestas. En el 47% de las preguntas sintéticas hubo al menos una opción que ningún respondente seleccionó. En las encuestas respondidas por personas reales, esto no ocurrió en ninguna de las preguntas analizadas.
Los resultados sugieren que, aun cuando las respuestas sintéticas parecen plausibles, pueden concentrarse en determinadas opciones y dejar fuera opiniones menos frecuentes que sí existen en la población.
Pew concluyó que, en su experimento, los datos sintéticos no reprodujeron adecuadamente la opinión pública y no los considera un sustituto de las encuestas a personas reales.
Más estudios, diferentes desafíos
Los resultados de Pew no son los únicos que invitan a examinar con cuidado el uso de respondentes sintéticos. Otras investigaciones de 2026 evaluaron su desempeño en preferencias económicas, precios y seguimiento de cambios.
1. Preferencias económicas en 74 países
Un estudio publicado en octubre de 2026 en Nature Human Behaviour simuló las respuestas de 67,201 participantes de 74 países a una encuesta global sobre seis preferencias económicas, como aversión al riesgo, paciencia, confianza y generosidad.
Las respuestas generadas por modelos de lenguaje explicaron el 1.3% de la variación entre individuos y el 4.2% de la variación entre países en las preferencias medidas. Además, los modelos acertaron la dirección de las diferencias culturales en el 48.1% de los casos analizados.
Aunque se identificó cierta alineación entre las respuestas sintéticas y las humanas, los autores concluyeron que todavía no son un sustituto confiable para encuestas representativas internacionales en análisis de gran escala o evaluación de políticas.
2. Precios y seguimiento en el tiempo
En julio de 2026, Research Live reportó una investigación de STRAT7 que comparó las respuestas de aproximadamente 3,000 personas reales en Reino Unido con datos generados por dos proveedores sintéticos.
En resultados generales, las respuestas sintéticas lograron aproximarse a los datos reales con diferencias promedio de dos a tres puntos. Sin embargo, al profundizar en ejercicios de precios, las respuestas sintéticas estimaron una disposición a pagar aproximadamente 16% más alta que la observada entre personas reales.
En un ejercicio de ordenamiento de precios —desde «demasiado barato» hasta «demasiado caro»— los respondentes puramente sintéticos rompieron la secuencia lógica el 68% de las veces. Al combinar datos reales y sintéticos, la inconsistencia se redujo a 32.8%, aunque no desapareció.
La investigación también evaluó la capacidad de identificar cambios entre mediciones. En uno de los análisis reportados, los datos sintéticos acertaron la dirección de los cambios en el 47% de los casos. En el seguimiento específico de awareness de marca, uno de los proveedores identificó correctamente el cambio interanual solo en el 19% de los casos y no detectó el movimiento real en 13 de las 16 marcas analizadas.
Los resultados muestran que aproximarse a cifras generales no necesariamente significa reproducir correctamente las relaciones, consistencias o cambios que son importantes para tomar decisiones.
Cuándo pueden ser útiles y cuándo conviene tomar precauciones
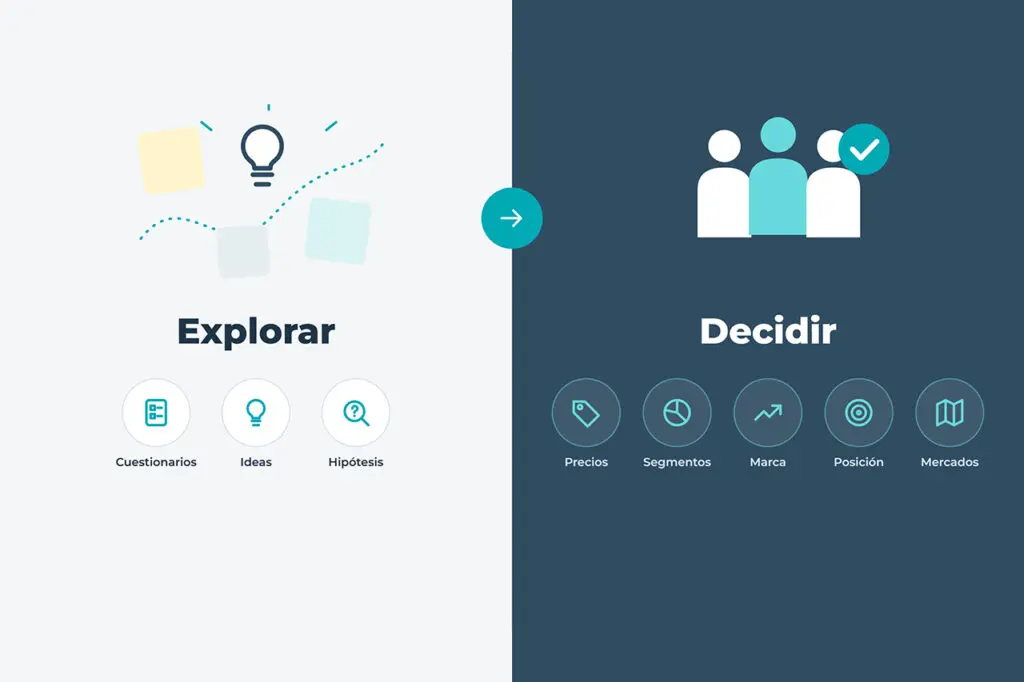
Los respondentes sintéticos no son necesariamente inútiles. Su valor depende del objetivo de la investigación, de la calidad de los datos con los que fueron construidos y del nivel de riesgo de la decisión que se busca tomar.
Pueden ser útiles para:
- Probar y depurar cuestionarios antes de aplicarlos a personas reales.
- Explorar ideas y filtrar conceptos en etapas tempranas de desarrollo.
- Generar hipótesis que posteriormente se validen con consumidores.
- Identificar posibles problemas en la estructura o lógica de una investigación.
Requieren especial cautela cuando se utilizan para:
- Determinar precios o estimar disposición a pagar.
- Definir segmentos y comparar grupos de consumidores.
- Medir cambios en la percepción de una marca a lo largo del tiempo.
- Evaluar categorías nuevas, marcas poco conocidas o reacciones a acontecimientos recientes.
- Representar poblaciones cuyas características y experiencias están poco presentes en los datos de entrenamiento.
La diferencia está en el alcance de la decisión. Una simulación puede ayudar a explorar una pregunta, pero cuando una decisión comercial depende de entender preferencias, diferencias entre consumidores o comportamientos reales, la validación con personas sigue siendo fundamental.
Por qué esto importa especialmente en México
Representar a un mercado como el mexicano implica reconocer que no existe un único perfil de consumidor. Las diferencias entre regiones, niveles socioeconómicos, generaciones, hábitos de compra y acceso a distintos canales pueden cambiar de manera importante las preferencias y decisiones de las personas.
Los estudios de 2026 muestran que los modelos sintéticos pueden tener dificultades para reproducir diferencias culturales y representar adecuadamente a determinados grupos. El riesgo es que una respuesta parezca lógica y consistente, pero esté basada en patrones generalizados y no en las experiencias de los consumidores a quienes se pretende entender.
Para las marcas que operan en México, estas diferencias no son un detalle estadístico: pueden determinar cómo se percibe un producto, qué motiva su compra, cuánto valor se le atribuye y qué barreras impiden elegirlo.
Cuando el objetivo es tomar decisiones sobre un mercado real, entender sus particularidades exige ir más allá de lo que un modelo supone y contrastarlo con lo que las personas realmente piensan, hacen y experimentan.
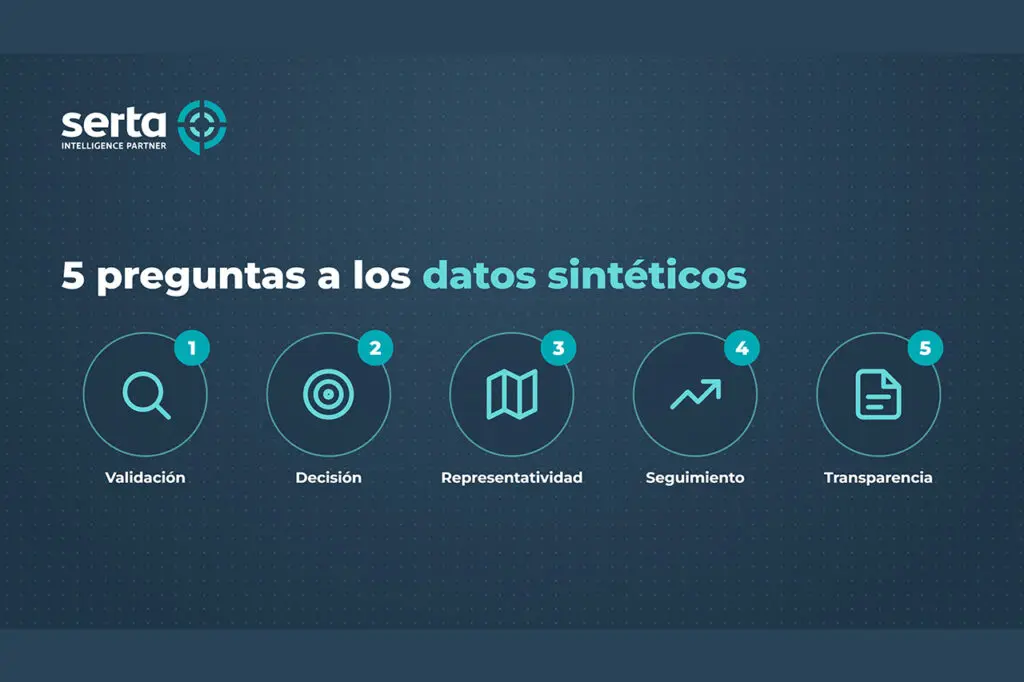
Cinco preguntas antes de tomar decisiones con datos sintéticos
Si tu empresa evalúa una solución basada en respondentes sintéticos, estas preguntas pueden ayudarte a medir su alcance y sus posibles riesgos.
1. ¿Con qué datos reales se validó?
Pregunta si las respuestas se compararon con encuestas a personas reales en tu mercado y categoría, qué indicadores se evaluaron y cuáles fueron las diferencias encontradas.
2. ¿Para qué tipo de decisión se usará?
No es lo mismo afinar un cuestionario o explorar conceptos que fijar un precio, definir una estrategia de marca o lanzar un producto. El nivel de validación debe corresponder a la importancia de la decisión.
3. ¿Representa a tu consumidor y a tu mercado?
Verifica si el modelo puede reflejar diferencias relevantes por región, nivel socioeconómico, edad, hábitos y canal, o si tiende a concentrar respuestas y simplificar perfiles.
4. ¿Puede detectar cambios de manera confiable?
Si necesitas seguir la evolución de tu marca, categoría o consumidor, pregunta cómo se comportan los datos sintéticos en mediciones repetidas y si se han comparado con cambios observados en personas reales.
5. ¿Qué tan transparente es la metodología?
Una investigación confiable debe explicar cómo se obtuvieron los datos, qué información se utilizó para construir los perfiles, cuáles son las limitaciones y cómo se controló la calidad de los resultados.
La diferencia está en la evidencia
La inteligencia artificial ya forma parte de la investigación de mercados y puede acelerar varias etapas del trabajo: diseño, análisis, procesamiento y visualización. Los estudios revisados muestran que los respondentes sintéticos pueden aproximarse a ciertos resultados generales, pero su desempeño es menos consistente al representar diversidad, relaciones entre variables, preferencias específicas y cambios en el tiempo.
La tecnología puede ayudar a explorar preguntas y abrir nuevas posibilidades para la investigación. Sin embargo, comprender preferencias, motivaciones y comportamientos reales requiere métodos que permitan escuchar y medir directamente a las personas.
En SERTA desarrollamos estudios de inteligencia de mercados con consumidores reales. Somos una agencia certificada con ISO 20252, la norma internacional para la investigación de mercados, social y de opinión, y diseñamos cada estudio de acuerdo con la decisión de negocio que necesita respaldar.
A través de nuestros estudios Ad hoc, de Usos y Actitudes e Insights, ayudamos a las empresas a entender qué piensan, qué valoran y cómo deciden sus consumidores.
Porque una respuesta que parece verosímil no necesariamente es una respuesta real.
En 2027, la velocidad para obtener respuestas será cada vez mayor. La diferencia estará en saber cuáles representan realmente a tu mercado.
Conoce cómo investigar a tu mercado con información confiable para tomar mejores decisiones.
Contáctanos en [email protected].
SERTA Intelligence Partner
Fuentes de consulta
- Pew Research Center — 30 de septiembre de 2026
Can AI Stand In for Human Survey-Takers? Not Really.
Estudio sobre la precisión de las encuestas sintéticas frente a encuestas reales. Incluye error promedio, diferencias por grupos y evaluación de diversidad de respuestas.
https://www.pewresearch.org/data-labs/2026/09/30/can-ai-stand-in-for-human-survey-takers-not-really/
- Pew Research Center — 30 de septiembre de 2026
How well synthetic polls capture the diversity of public opinion.
Análisis de las opciones de respuesta no seleccionadas por participantes sintéticos y diferencias en la distribución de opiniones.